AI生图做日用百货主图:包装上哪些字必须原样留住
十月二十九号,周二,下午三点二十。客服转来一张截图,买家只有一句:你们图上写八十八抽,我收到的是八十抽。
截图是我们上周上的抽纸主图,浅绿植物背景,绿色包装正面主标「云感柔肤」,底下一行「88抽3层·无香」。我盯着那个 88 看了半分钟才看出来,两个 8 的下半圈被连成一笔,远看是 88,近看像 80。
小唐凑过来说,原图不是八十八抽吗。我说原图是,图上不是。
那行参数条,是上一版就改坏的
这张图不是头一回出事。前一版「柔」的三点水被抹成两点,再前一版「压」少了一横。当时都觉得没事,缩略图上看不出来。
买家不看缩略图。他收到货,拆开,把包装摆在桌上,再对着手机比。图上的字是他下单前的承诺,两样对不上,解释什么都晚。
抽纸正面那行「88抽3层·无香」糊了,买家判断值不值的依据就没了。这个类目不靠版型说话,靠字说话;字是信息,信息就有对错。
包装上的字分三种,边界完全不一样
我们按"改错了会怎样"把字分成三类,不看大小位置,只看后果。
法定信息:净含量、规格、材质成分、执行标准编号、生产许可类字样、保质期、厂商地址。一个字都不能动,也不该让模型碰。改一个数字,轻则下架,重则涉及计量与标识合规。处理方式只有一种:真实包装实拍,或者把原字压回去再和实物对一遍。
卖点承诺:柔软、加厚、三层、几抽、原生木浆、深层过滤。这是商家对买家说的话。词可以挪位置、改字号、换颜色,词本身和里面的数字不能变。三层写成四层是虚假宣传,八十八抽写成一百抽也是。模型偏偏爱把它重组成读起来顺、意思变了的句子。
装饰氛围:品牌口号、情绪词、「云感柔肤」这类感性描述、背景英文小字。这一类有余地,可以让模型重排。前提是不带数字、不带绝对化用语,带了的自动归到上一类。
边界不在字数,在于有没有人拿它当依据。拿净含量算单价,拿层数判断厚度,拿「无香」判断能不能给婴儿用——凡是有人凭它做决定的,都碰不得。
模型眼里没有字,只有一片纹理
得先接受一个事实:图像模型不认识汉字。
它看到的不是「净含量 560ml」这几个字符,而是一片密集的深色笔画,聚在包装某个矩形区域里。它学过大量"包装上该有字"的样子,于是照着生成一片形状——粗细对、疏密对、位置对,内容不对。
隔着毛玻璃看街对面的招牌,你能认出那是三个字,甚至猜得出是家什么店,但复述不出来。模型一直在隔着毛玻璃抄写。
更麻烦的是像素预算。一行字要在画布上分掉一段宽度,字越多,平摊到每个字的像素就越薄。笔画之间的缝先消失,随后横竖粘连,再往后整个字塌成一块色。参数条因此永远是重灾区。
所以"提示词写细一点"没用。模型读到"这里该有一片字"就到此为止,它没有"这是净含量"的概念。
生图能力说明里那句"模型擅长场景和光影,不擅长排版",放在日用百货里值得放大十倍看。
三个位置最爱出事:主标、参数条、封口
正面主标。字最大,最容易被放过——远看真像,轮廓都在。问题全在细节:三点水糊成两点,「柔」下半的木字旁少一撇,两个相同的字写得不一样。大字出错概率低,出错后却最难发现,大脑会自动补全熟悉的字形。
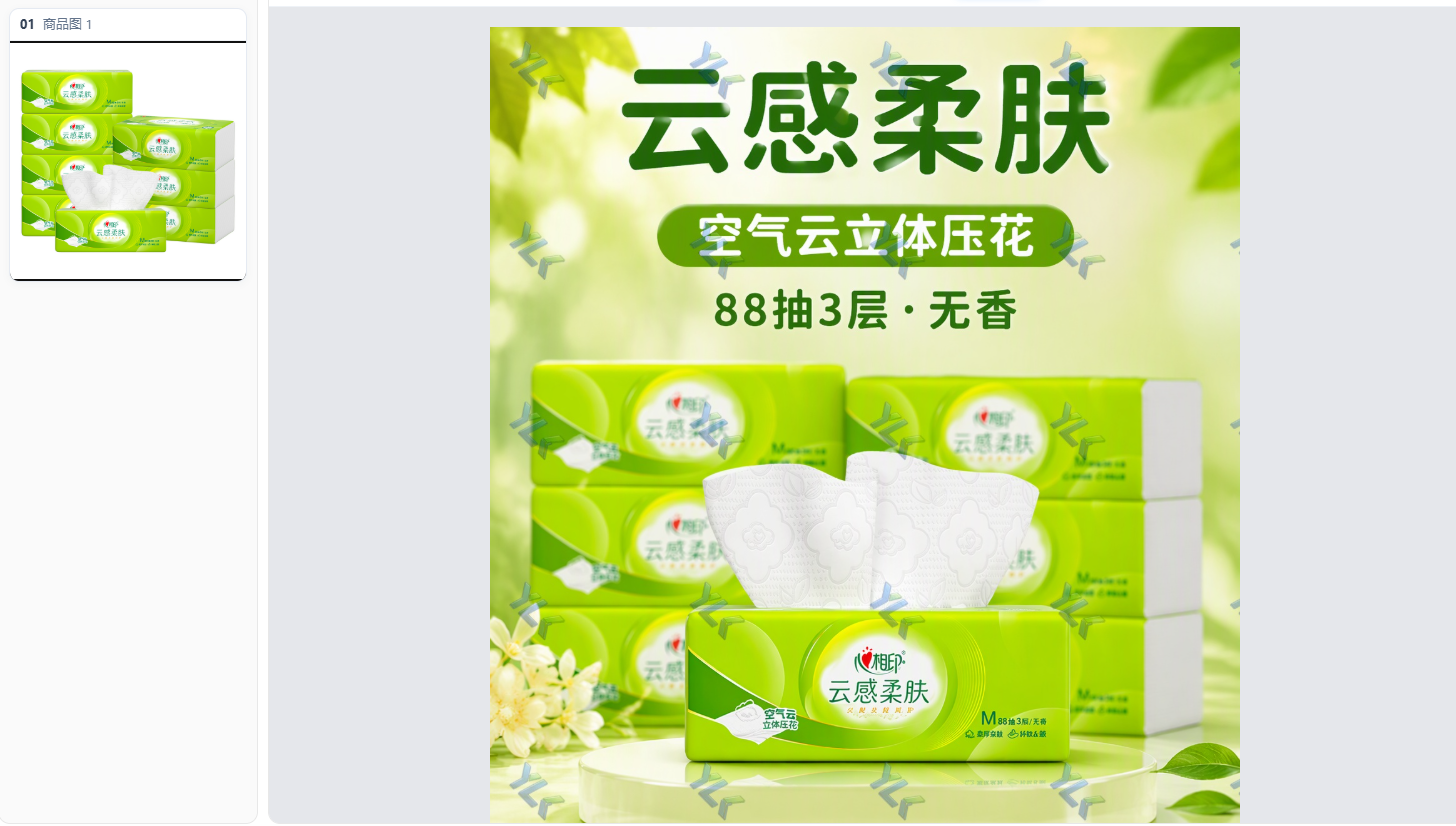
主标和参数条在同一张脸上,得分开看:主标看字形有没有被改写,参数条看数字和单位有没有被重组。
侧面参数条。真正的重灾区。一行塞着数字、单位、分隔符、几个卖点,字号小到列表页里根本不存在。模型在这里最常干的不是写错,是合并——「88抽3层」压成「8抽3屋」,「深层过滤·纯净口感·健康好水」揉成一串读不出意思的字。
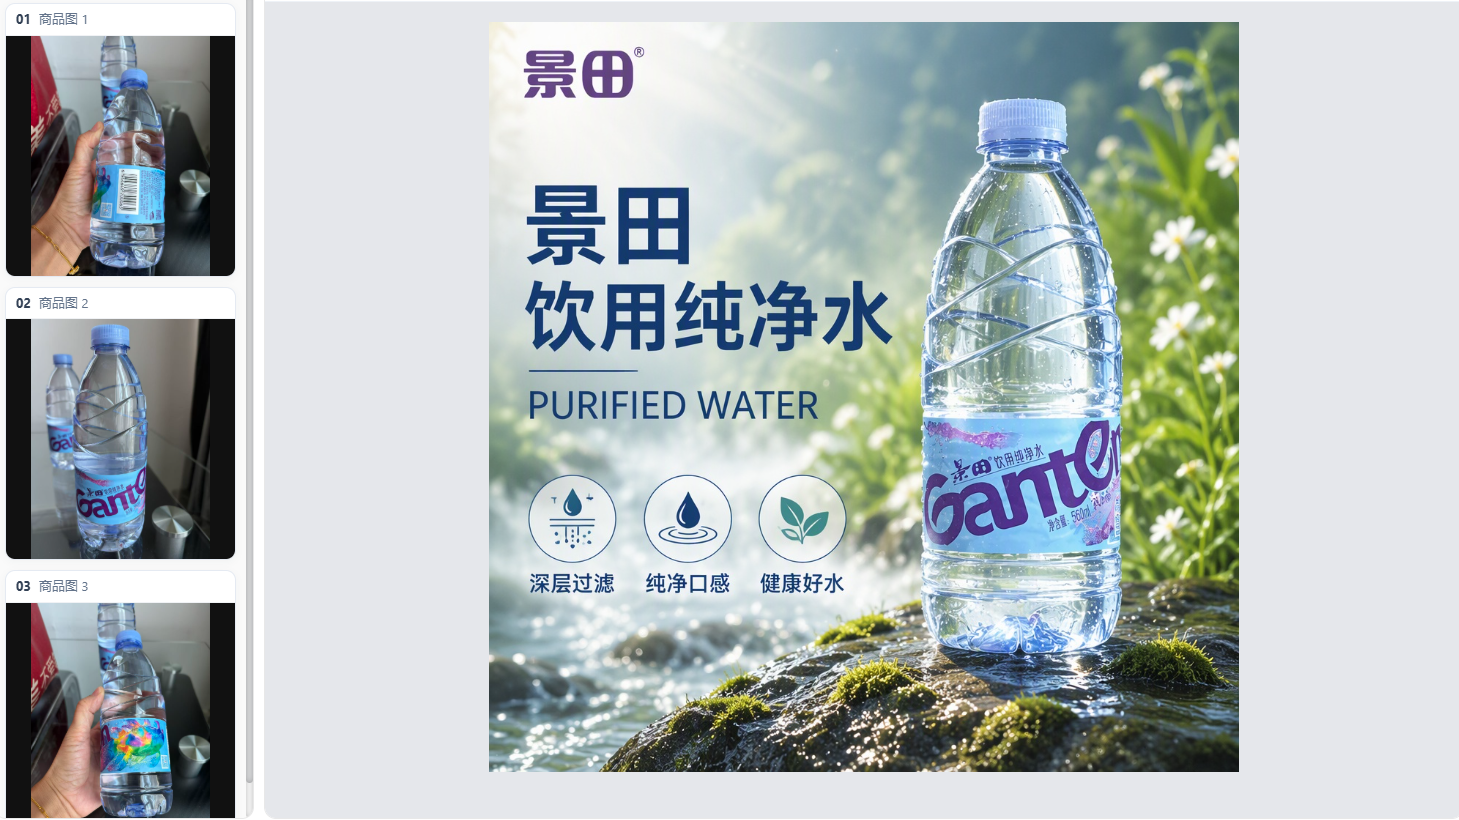
瓶身是圆柱面,标签字跟着曲率被拉伸。这种位置上的小字,模型给出的通常是一串"看着像英文"的形状。
口部与封口处。抽纸的封口贴、瓶盖下面那圈、牙刷盒的封边。曲面、高光、边缘压缩叠在一起,字连"像"都做不到,处置最省事——换角度让它转过去。
四种做法,每种都要付代价
留空回贴。生成时把文字区描述成干净的浅色块,出图后用排版软件压字。最稳,也最贵。软包装有褶皱,硬包装有倒角,圆柱有曲率,字都得单独做变形,做不好比模型画的更假。一张多十几分钟。
把字号做大。关键数字放大到模型能咬住的程度,主标占到正面三分之一以上,笔画能对个七八成。代价是构图被字吃掉,产品变小,场景让位。
参数条图形化。把「88抽3层·无香」换成三个色块,每块放一个短词或图标。模型画色块稳得多,它画的是面积和边界,不是笔画。代价是信息量下降,买家得猜,文字变图形后视觉占比反而上升。
换角度避开。侧面转四十五度,封口朝里,瓶盖那圈转到背光侧。成本最低,代价是少一个面。有些品类绕不开——牙刷盒三面都有字。
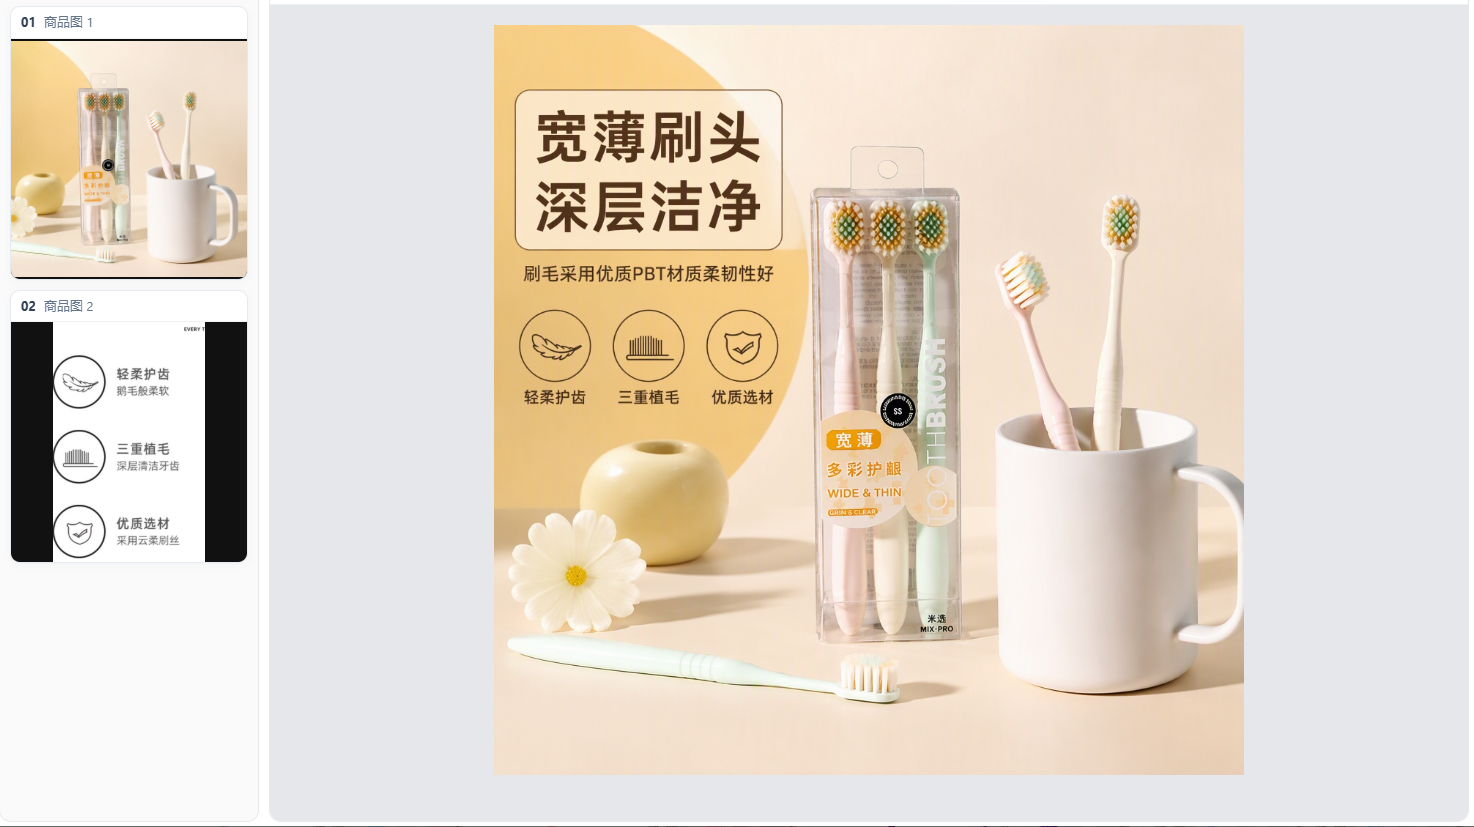
盒和产品同框,最该对齐的是两处:盒上的规格和产品对不对得上,盒上的卖点和主图文案是不是同一句。
四种没有优劣,只有配比。
三个尺寸,各看一件事
缩到列表尺寸。两百像素宽,也就是搜索结果里的大小。这个尺寸什么都读不出来,也不该读。要看的是文字区糊成一块脏色,还是仍留着排版节奏。
放大到百分之二百。唯一能抓出改字的尺寸。看三样:横竖有没有断笔;闭合结构(口、日、田、回)有没有封口;易混的字对有没有互换,0 和 8、3 和 8、抽和油、层和屋。
和实拍并排。把主图和真实包装照片缩到同宽,左右摆开,眼睛来回扫。方法笨,但抓"多一行少一行"特别准——模型有时凭空补一行小字,或把三行卖点压成两行,行数和每行的起止位置会直接跳出来。
三个尺寸有先后。先缩,过不了的直接弃;再放,看笔画;末了并排,用实拍终审。顺序反过来很浪费,我试过先放大看字,字全对,缩略图上看整个包装是歪的。
有些图不该整张交给生成
法定信息密集的包装正面,我们不再交给生成。净含量、执行标准、厂商信息挤在一起,能画对一两个,剩下靠猜。现在改成实拍打底,生成只做背景和光影。
需要精确计量的参数也不交。八十八抽和八十抽差十二个百分点,模型只知道形状像。条码和二维码更碰不得,它不是字,是图形,模型给的是一块"看起来像条码"的条纹,扫不出来。
能交出去的是另一半:场景、桌面、背景植物、光线方向、产品在画面里的位置关系。这些恰恰是拍摄最费时间、生成最省时间的部分。两半分开,返工就少。
至于雨林凯AI(简称雨林凯)的这批图,跑之前会先把包装拍照存档,把三类字标出来,再定哪一块留空。不省时间,但"字被改了"从随机事件变成了能提前拦住的事。
收尾说句不太好听的:模型改字不会因为版本更新就消失。只要它是把形状当纹理画,小字就永远在赌。能做的是别把有法律含义的东西放上赌桌。
常见问题
Q:包装上的字被模型改了,重新生成能不能碰对一次?
小字不行,大字偶尔可以。笔画占的像素太少,每次都在同一处信息不足。
Q:净含量这种数字,模型写对了就能用吗?
不建议。数字对不代表单位对,单位对不代表旁边那行小字也对。
Q:卖点可以重排吗,换行、换颜色算不算改?
位置、字号、颜色可以动,词和数字不能动。
Q:留空回贴听起来最稳,为什么不全这么做?
因为贵。字要跟着曲面走,一张图多花十几分钟。
Q:主图上文字占比太大,会不会影响平台审核?
会。各平台对文字面积的要求不一样,色块占的比字更多。