印花提取跑几十上百张,怎么做到不漏、不错、不串|雨林凯AI
周三晚上十点四十,我们把一批手机壳用的印花提取跑完了。八十七张源图,我自己手动剔掉两张重复拍摄的,实际要处理八十五张。工具那边进度条走满,显示全部完成,我把结果目录打了个包丢进工作群,关电脑去睡了。
第二天早上九点半,负责上新的同事在群里发了一句:"这批是不是少了点?我数下来八十三张。"我第一反应是数错了吧,打开文件夹从头点了一遍——确实八十三。又往下翻,翻到一张文件名写着"柴犬樱花"的,缩略图却是只橘猫,白底,正对着镜头。
那两张凭空消失的,和那张名字挂错的,都不是工具的问题。八十五张源图进去,工具老老实实跑了八十五遍。问题出在中间那一层没人看着的地方——我已经搭好的编号,我在中途顺手改过的一个名字,还有一个被后跑的批次悄悄覆盖掉的文件。
从那以后,我们内部把批量印花提取的最后一道工序单独拎了出来,叫它"对账"。它不难,就是烦,但正是这一步把"跑完了"和"能用了"分开。这篇文章,就写这一步。
单张靠眼睛,八十几张就得靠流程
先承认一件事:印花提取这个动作,做一张的时候几乎不会出错。你把源图放进去,框一下图案,几秒钟透明底出来,对不对你一眼就知道。看得见的东西,人不太会搞错。
批量把这套机制拆掉了。
八十五张,你不可能对着每一张结果跟源图并排核对。退一步说,就算你愿意看,看二三十张之后注意力也会滑坡,前面看得细,后面就开始"差不多就行"。人眼是会被疲劳骗的,而工具不会告诉你它骗了你——进度条走满的那一刻,界面给你的信号是"全部成功",没有一个地方会跳出来说"这一张内容其实不是你想要的"。
所以批量的风险性质变了。单张的时候,出错是一起画质事故,你当场就能改。批量的时候,出错更像一起账目事故:流程一路绿灯,缺的、错的、串的,全都安安静静地躺在结果里,等到汇总或者是上新前那一刻才一起冒出来。而那一刻,往往离你的交付时间最近,也最狼狈。
这也是我们反复说的一句话:批量的质量,不在生成那一步,在生成之后你对不对得上账。
事故分三种:漏、错、串,疼的地方完全不同
批量跑完,能出的文件级事故其实就三类。分开看,是因为它们的成因、发现方式和补救成本都不一样,混在一起想,很容易治错了地方。
漏,是该有的一件没有。八十五张源图进去,出来八十三张,少的是哪两张?如果编号不连续、名字没有规律,你甚至说不清少的是哪两张。漏通常来自中途失败没被记录、或者被后来的一次重跑覆盖掉了名单。它最容易被忽略,因为少的那张不在你眼前,你不会觉得自己丢了东西。
错,是文件在,但里面装的不是它该装的内容。多见于排序或者映射错位:你以为第 7 张是给手机壳 A 提的,其实文件里是给手机壳 B 提的。错在数量上完全看不出来,只有内容核对才会现形。
串,是最别扭的一种:图案是对的,源图也是对的,但名字挂到了别人身上。你拿着"柴犬樱花"这个文件名,打开看到的是一只橘猫——图没坏,只是它认错了门。串的成因通常是重名覆盖,或者中途有人改了名,而下游还在按老名字找。
三种事故,漏最隐蔽、错最难查、串最容易被当成"工具抽风"。但它们共用同一套防线,就是我们下面要搭的三张清单。
三张清单:输入、输出、映射,缺一张就对不清
对账这件事听起来玄,落到实处其实就三张清单。它们的顺序和来源都很清楚,谁也别想跳过谁。
输入清单是从源图来的。你在动手之前,先把这一批要处理的源图列出来,给每一张一个编号,记下它原本的文件名和它对应的商品。这张清单的作用只有一个:告诉未来的你"本来应该有多少、分别是哪些"。它必须在提取之前就存在,事后补是补不回来的。
输出清单是从结果来的。每跑完一张,就往里记一条:结果文件名是什么、什么时候生成的、用的哪张源图。它不是给你看的,是给机器对的。理想情况下,输出清单能从结果目录直接扫出来,不需要人手动敲。
映射表是把前两张接上的那一根线。第 12 号源图,对应输出里的哪一个文件名?这张表就是"谁出自谁"。数量查靠前两张,内容查就得靠它。映射表一旦写清楚,后面所有"这张图到底来自哪"的问题都能一句话答上来,不用再翻聊天记录猜。
我们内部有个硬规矩:没有映射表的那一批,不算跑完。哪怕图全都对,也算没跑完——因为它没法被验证,也没法被复用。
命名陷阱:零填充、数字序、跨系统排序
三张清单能不能自动对上,八成取决于命名。命名这件事,人看着无所谓,机器看着天差地别。
第一个坑是零填充。你今天图省事,把文件命名成 1.png 到 85.png。看起来没问题,直到你按名字排序,发现顺序变成了 1、10、11……19、2、20、21。因为字符串比较是从左往右一位一位比的,"10"的第一个字符是"1",跟"1"一样,第二个字符"0"比空小,于是它排在"2"前面。这个顺序,和你源图的拍摄顺序对不上,映射表一按名字生成,就整排错位。解决办法很朴素:统一补零,001.png 到 085.png,宽度一致,排出来就是你要的顺序。
第二个坑是数字序和字典序不是一回事。有些工具、有些文件管理器会自动"聪明"地按数字大小排,有些则老老实实按字符排。你以为两边看到的是同一个顺序,其实不是。这种差异最阴险的地方在于——两边都"看起来很有序",你不会怀疑。
第三个坑是跨系统排序不同。同一个文件夹,在你的 Windows 上和在同事的 Mac 上,排出来的顺序可能不一样,尤其中文名、带特殊符号的名字、大小写混着来的时候。所以我们的建议很直接:不要在两边各自排序然后互相比,而是以清单里的编号为准。编号是死的,排序是活的,永远信编号,不信排序。
这三个坑单拎出来都不大,凑在一起就能让你错一整排。命名规范不是为了好看,是为了让机器和你看到同一个世界。
串号从哪来:排序不同步、同名覆盖、中途改名
前面把"错"讲得多,这里单独说说"串",因为它最容易被误判成工具不稳。
第一种来路是排序不同步。你按源图的顺序建了编号,工具却按自己的顺序读入,两边差了一位。结果就是所有输出整体平移一格,每张图的名字都挂到了相邻那张身上。这种错位的特征很明显:不是零星错,是一整片连续错,而且往往从中间某一张开始。
第二种来路是同名覆盖。这批跑完,发现有两张做出来不满意,你改了参数重跑那两张。重跑时如果没有单独的输出目录,新的结果就把旧的正主覆盖了,而旧的那张可能才是你真正要的。更麻烦的是覆盖不报错,你只会觉得"怎么少了一张",其实是两张变成了一张。
第三种来路是人到中途顺手改了个名。这是最人的一种错误。跑到一半,同事觉得"手机壳A-正面"这个名字不好看,改成了"正面图案",但下游的映射表还是按老名字记的。图没动,名字动了,账就对不上了。所以我们内部有条不近人情的规定:批量跑到一半,谁都不许改文件名。要改,等对账做完、落库之前统一次改。
三种来路,凑成一句经验:串号几乎从不来自工具,来自流程里两次"顺序"对不上。
对账三查:数量、映射、抽检
清单备好,接下来是对账本身。我们把动作压成三查,顺序不换。
第一查是数量。输入清单有多少条,输出清单走完应该在多少条。少的要能说出少在哪,多的要能说出多的是谁——多出来的通常就是覆盖或者重复跑留下的幽灵文件。这一查最快,也最该第一个做,因为数量不对,后面的映射查就是在错误的集合上做数学题。
第二查是映射。逐条对:第 N 号源图,对应的输出文件在不在、编号连不连、有没有两个号指向同一个文件。这一查能揪出所有的"错"和大部分"串"。它枯燥,但它是唯一能证明"每张图都出自该出自的那张源图"的动作。做的时候不要用眼睛逐行扫,让清单之间做比对——人眼扫两百行一定会漏。
第三查是抽检。数量对、映射对,仍然不能保证内容对,所以最后要真正把源图和结果并排看。这一查看的不是"数字对不对",是"这张图是不是它自己"。抽检的比例和方法,后面单独讲。
三查里,前两查是防"漏"和"错",第三查是最后一道兜底。很多团队只做第一查,觉得数量对上了就万事大吉,结果一上新才发现内容串了。
断点续跑:中断之后别整批重来
八十几张的批量,跑起来要时间,中间断一次很正常。断在哪里,怎么接着跑,是批量作业里最考验流程的一环。
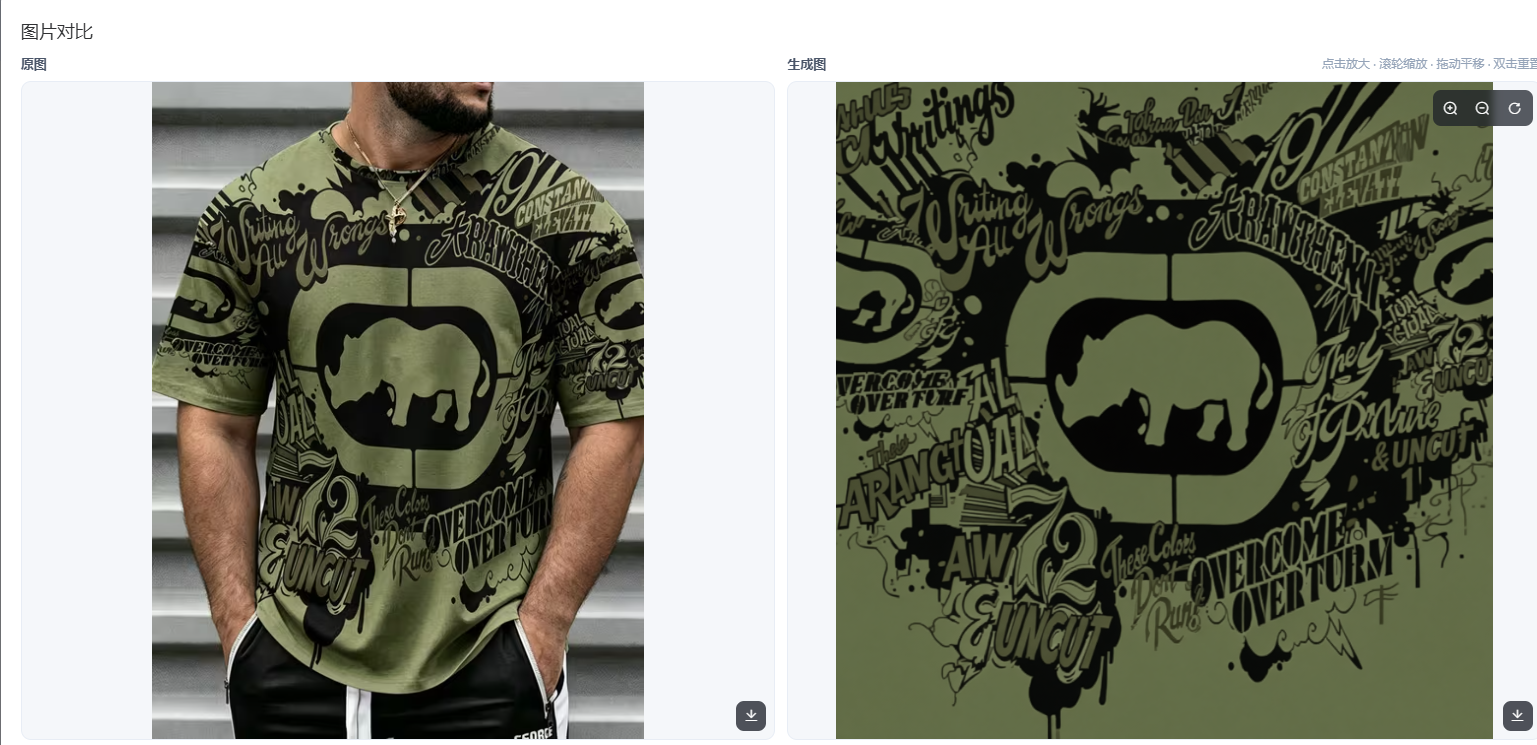
像上面这种墨绿满印、密集英文字体涂鸦、中央还嵌一个野牛剪影的图,是整批里最费工的一类。它和一张干干净净的单个logo,跑起来耗时可能差好几倍。也就是说,一批图跑到快结束的时候,往往还剩几张最慢的在排队。如果这时候断掉,最慢的那几张大概率就是没跑完的那几张——如果整批重来,你等于把最贵的那部分又跑了一遍。
我们的做法是留一个中间态目录,外加一份已完成清单。每跑完一张,就往清单里记一条;断掉之后重启,先读清单,已经做完的直接跳过,从第一张没记录的接着跑。这样重跑只补缺口,不碰已完成的部分。
中间态目录还有第二个好处:那些"跑到一半、还没成"的图,有一个明确的暂存位置,不会混进最终结果里冒充成品。我们见过太多把半成品和成品堆在一个文件夹里,对账的时候数量对得上、内容却五花八门的情况。半成品就该待在它自己的地方,等它做完再搬出来。
一句总结:批量作业要能"从断点接着跑",而不是"从头再来一遍"。这不是效率问题,是正确性问题——重跑正是同名覆盖最常见的诱因。
失败清单要分级:图的问题,还是参数的问题
跑到最后,总会有几张没成功。这几张怎么记、怎么处理,直接决定了你是十分钟收尾还是半天返工。
别看"失败"两个字,它其实分两类,成因完全不同。一类是图本身的问题:源图太糊、图案和背景颜色贴得太近、边缘有遮挡,工具无从下手。另一类是参数的问题:源图没问题,是你这次的设置不适合它,换个思路能救。
分级的意义在于处理动作不一样。图本身有硬伤的,别在参数上浪费时间,直接标记成"源图不可用",从这批里摘出去,计入失败清单的稳定项。参数的,值得再试,而且有讲究——同一张图,我们最多试到第三次。
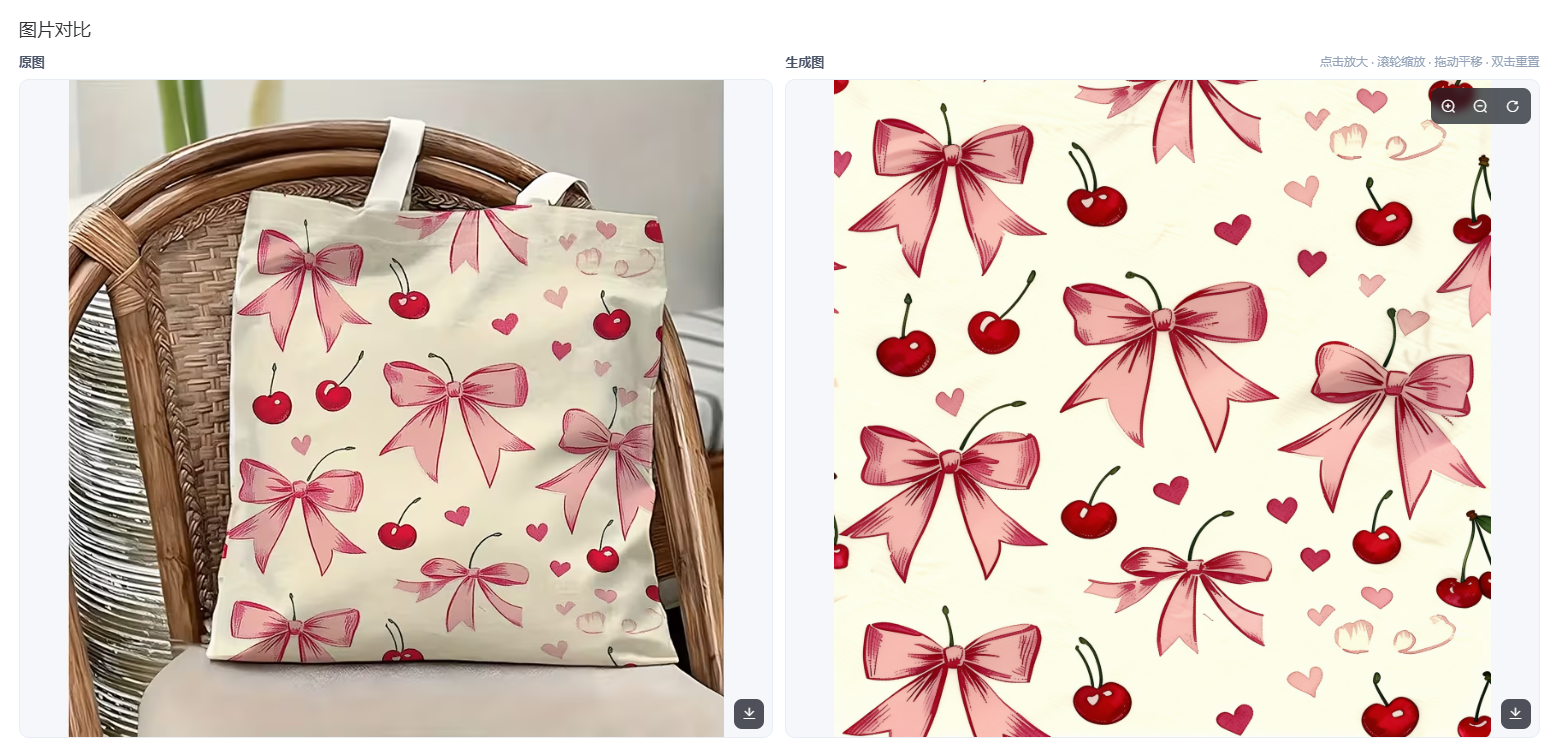
上面这个米黄底托特包就是很好的例子。它满印粉色蝴蝶结、红樱桃和爱心,颜色本身不复杂,但底色和图案的明度接近,提取后米黄底色没有去干净。单看这一张,你可能会想"是不是风格就这样",甚至会犹豫要不要接受。但放到一批里看,如果十几张帆布包都留着这层底色,那它就不是风格,是一类系统性偏差——处理动作应该是统一调参重跑,而不是一张张手动接受。
分级还有一层好处:它让失败清单"每一张都有归属"。要么进重跑队列,要么进待复核,要么明确判死。最怕的是一句"这几张不行"就搁那儿,过两天没人记得为什么不行、该怎么补。
三次换源止损:跟一张图死磕是最贵的
接上面那条"最多试到第三次",我想把它单独拎出来说,因为这是批量里最烧钱的一个隐形坑。
一张图救了两次还是不行,人的心态会变——已经花了两轮时间,这时候放弃像亏了,于是第三次、第四次接着试。这就是典型的沉没成本。可在批量作业里,你在一张图上多花的每一分钟,都不是从空气里来的,是从后面几十张的注意力里抠出来的。前面死磕太久,后面就会草草收尾,整体质量反而被拉低。
我们的止损线定得很明确:同一张换到第三次还不行,就换源。换源的意思不是放弃这个图案,是回去找一张更好的原始素材——更清晰的实拍、角度更正的图、或者干脆重新拍一张。很多"怎么提都提不干净"的图,根子在源图,不在操作。换一张源图,可能十分钟搞定;在原图上继续磨,可能是又一个小时。
加一条纪律:止损要成批做,不要边跑边纠结。跑的时候先跑,跑完统一看失败清单,集中判断哪些换源、哪些判死。边跑边判断,节奏会被单张拖住,整批就散了。
抽检分层:按品类、按复杂度、上新前全检
抽检这一步,最多的误区是"随手点几张看一眼"。随手抽等于没抽,因为随机的落点永远偏向那些一眼正常的图,真正有问题的系统性偏差,恰恰藏在"看起来都一样"的那一堆里。
我们的抽法是分层。按品类分层:这一批里有手机壳、有马克杯、有帆布包,那每一类都要抽到,不能只抽数量最多的那一类。品类不同,源图的拍法和背景差别很大,一个品类里正常,不代表另一个品类也正常。
按复杂度分层:这是最容易被跳过、也最该抽的一层。单个 logo、纯色图形这些简单的,随便看两张就行;但密集文字满印、多元素堆叠、颜色彼此贴近的,要单独多抽几张。前面那张满印圆标就是这个道理——它的风险不在"好不好看",在提取之后细微的文字糊不糊、颜色串不串,这些只有并排看才看得出来。
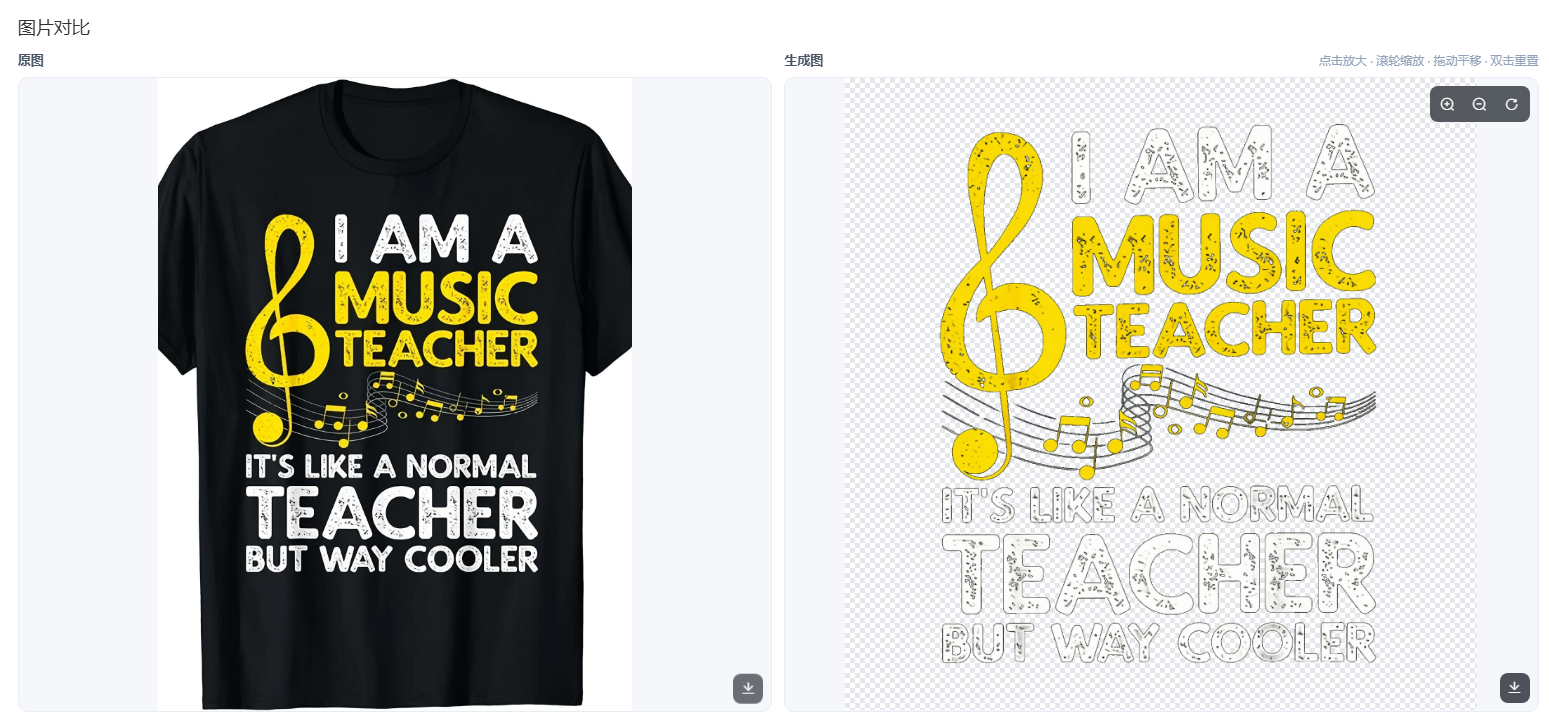
拿这件黑色T恤说,黄色做旧的高音谱号和音符,配上白黄文字。做旧的颗粒感保留得不错,问题出在那几行白字——边缘略微发灰。单抽到这一张,你可能觉得是偶然,是这张源图的问题。但如果抽检时多拿几张深底、带白色文字的图一起看,白字发灰就会变成一个规律:它是一类被背景色影响出来的系统性偏差,该处理的是参数,不是这几张图。
所以抽检的最后一层是上新前全检。日常批次抽一成大致够用,但一旦这批图要直接进主图位、要上新、要对买家展示,那关键图就不该只靠抽样了,宁可一张张过。抽样是效率工具,不是免责工具——它降低的是成本,不是降低你该承担的正确性。
落库接口:成果别堆在下载文件夹
对完账,最容易被忽略的一步是把结果送进该去的地方。很多人的批量成果最后躺在下载文件夹里,文件名还带着临时编号,用一次就再也找不着了。
批量其实是最好的落库时机。因为这时候你手里同时有清单、有映射、有统一的命名,正好可以一次性按规范改好名、分好目录、送进资产库。等这几张图散落开来再回头整理,成本要高得多,而且一定会有漏网的。
落库的关键是"批量收尾直接按规范命名"。也就是说,别等到用的时候再改名,而是在对账做完、判定这批合格的那一刻,统一按"品类-主题-规格-版本"这样的规则重命名,然后整批入库。这一步做在收尾,省的是未来每一次查找的时间。
还有一点:落库要留下那一批的映射表。半年后你想知道某张图是从哪张源图来的、属于哪一批,映射表是唯一的线索。文件本身的元数据会丢,聊天记录会清,只有那张表还在。
返工成本账:十分钟对账,抵半天返工
为什么我们坚持把对账写进流程,而不是"看情况做"?因为算笔账就清楚了。
对账本身花多久?熟练之后,八十几张的一批,三查走完大概十来分钟。而且这十来分钟是"稳赚"的——它把风险拦在交付之前。拦下来的每一起事故,省下的都是后面几小时甚至几天。
不对账会怎样?最轻的一种是上新时发现少了两张,你得重新翻源图、重新跑、重新入库,还要一路追查它到底是漏了还是被覆盖了,半天就这么没了。重一点的是名字串了,图发到了错误的商品详情页,买家看到的和描述对不上,售后、差评、链接重做,一起压过来。最重的是整套货盘的图案和商品的对应关系乱了,一批几十个 SKU 全得回炉核对,那不是半天,是几天。
十来分钟换半天起步的返工,这笔账怎么算都值。真正的问题从来不是"对账值不值",是"人总觉得自己这批不会出事"。可事故从来不挑批次,它挑的是没有防线的那一批。
收尾判据:三条同时满足,这批才算跑完
最后给一个明确的收尾标准。别再用"我看着差不多齐了"来判断,用三条硬判据。
第一条,数量齐。 输入清单有多少,输出清单就对得上多少,多出来的和少掉的都要能说出名字。数量这一条不过,直接打回重跑,不用往下看。
第二条,映射一一对应。 每一个输出文件都能追溯到唯一的源图,每一个源图都能找到它对应的结果,没有一对多一,也没有孤儿。映射这一条不过,说明"错"或"串"还有残余,必须查清。
第三条,失败清单每一张都有归属。 没成功的那几张,全部有明确处理:进重跑队列、换源、判死,三选一,没有"待定"。收尾时最该警惕的就是"这几张回头再说"——回头永远不会来。
三条同时满足,这一批才算真正跑完,可以落库、可以上新。少一条,都不算。
回到开头那批八十五张。我们后来补回了两张漏的,重新提取了那张挂错名字的橘猫,把映射表从头核了一遍。整个补救花了将近两个小时,而如果当晚跑完就花十来分钟对一遍账,这两小时根本不会存在。这次之后,那三张清单就固定进了我们的流程,谁跑批量都得先立起来。
印花提取这个功能,本身已经足够省事——新用户有免费额度,跑几十张不费什么力气。但省事的地方恰恰最考验人:工具把生成变便宜了,流程的正确性却一点没变便宜。它只能靠你立清单、做对账、守住那三条判据。跑得越多,这一步越不能省。因为批量给你的从来不是"更省心",是"更值得被认真对待的数量"。
常见问题
问:印花提取一次跑几十上百张,最容易出的是哪类问题?
答:不是画质问题,是文件级问题,一共三种:漏(该有的一张没生成)、错(文件在但内容不是它该有的那张)、串(图案没错,名字却挂到了另一张源图上)。这三种都不会当场报错,往往要在汇总或者上新前才露头。
问:为什么单张提取很少出事,一上批量就开始出错?
答:单张你是逐张盯着看的,错了立刻能发现。批量之后人不可能再看每一张,注意力被摊薄,判断从眼睛转到了流程。流程里任何一处命名或排序不一致,都会被放大成整排的错位,而且它不会自己跳出来提醒你。
问:对账到底要查什么,有没有顺序?
答:三查,顺序不能换:先查数量,输入清单一共有多少、输出清单就有多少;再查映射,每个结果都能对上唯一的源图编号;最后抽检,把源图和结果并排看,确认内容确实是同一张。数量不对,后面两查都白做。
问:跑到一半中断了,直接整批重跑行不行?
答:不建议。重跑会把已经完成的部分再算一遍,浪费时间,还会因为同名覆盖把先跑的好结果替换掉。正确做法是留一个中间态目录和已完成清单,重跑时按清单跳过做过的,只补没做完的那部分。
问:抽检抽多少张才算数?
答:没有固定比例,我们内部大致按一成起步,但重点是分层而不是随手点。按品类分一档、按复杂度分一档,密集满印、文字量大、颜色贴近的单独多抽;上新之前的那批,关键图宁可全看一遍。